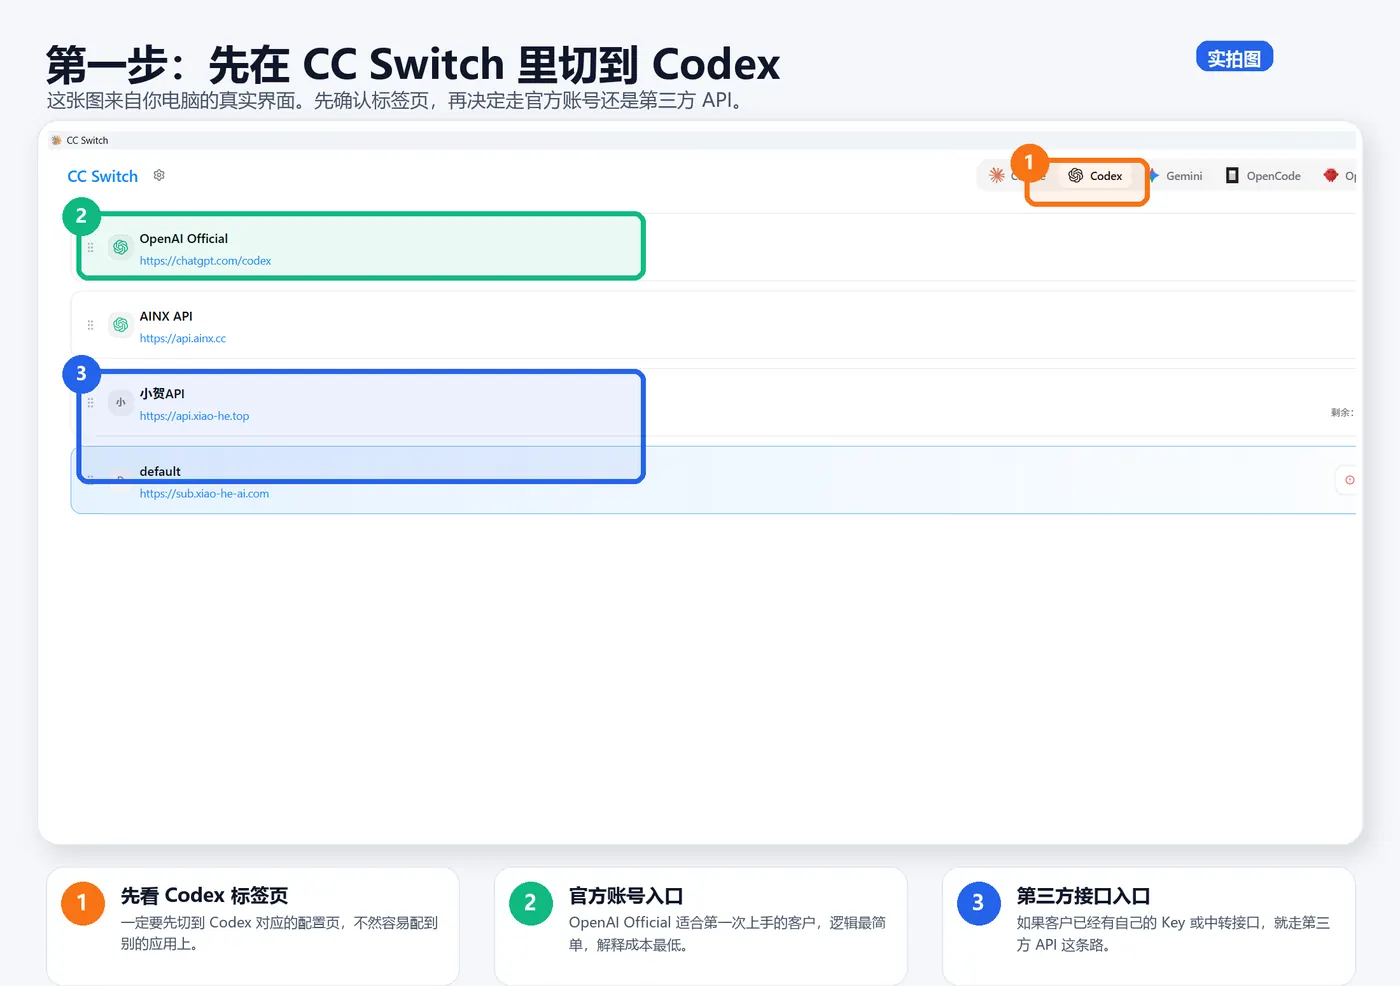
第一个 Skill 可以只做一件小事:读取任务 JSON,统计 done 与 todo,并列出未完成任务 ID。下面用教学样本跑通“发现 Skill → 读取说明 → 按约定输出”。它不证明真实业务流程已经稳定,投入日常工作前还要用实际材料回归。
放进当前项目的发现目录
准备一个独立练习项目,在项目中建立:
skill-demo/
  .agents/skills/task-status-summary/SKILL.md
  input/tasks.json
项目 Skill 使用 .agents/skills。当前官方文档也说明了用户级 ~/.agents/skills 等作用域。先只用项目目录,避免无意影响其他仓库;不要把旧资料里的任意技能路径都当成当前默认路径。
以下为完整的 SKILL.md。开头 YAML 的 name 与 description 是入口元信息,后面的正文说明如何完成任务。
---
name: task-status-summary
description: 当用户要求统计任务JSON中的done和todo数量并列出未完成任务ID时使用;不用于解释任意表格、改写任务或自动变更状态。
---

# 任务状态汇总

输入:用户指定的一个 UTF-8 JSON 文件,顶层为数组。
每条记录必须有唯一的非空字符串 id、非空字符串 title、status。
status 只允许 done 或 todo。

操作:
1. 只读用户指定的输入文件,不搜索无关目录。
2. 先检查 JSON 是否可解析、字段是否完整、id 是否重复、status 是否在允许范围。
3. 任一检查失败,停止统计,指出记录位置与字段问题;不补造默认值。
4. 有效输入按 status 计数,保留 todo 的原始 id,按输入顺序列出。
5. 只在对话输出结果,不修改输入文件,不运行发布或通知动作。

输出:
- 总任务数
- done 数
- todo 数
- todo ID 列表(无待办时写“无”)
- 一句检查:done + todo 是否等于总任务数

不要把 todo 推断成逾期,也不要根据标题猜任务是否已完成。
description 用来说明什么时候用,正文才负责执行细节。不要把所有场景塞进 description;触发太宽会让 Skill 被用于不符合输入约定的任务。
正常样本与明确预期
把下面内容保存为 input/tasks.json:
[
  {"id":"T-01","title":"修改副标题","status":"done"},
  {"id":"T-02","title":"检查移动端","status":"todo"},
  {"id":"T-03","title":"核对来源链接","status":"todo"}
]
在同一个项目的 Codex CLI 或 IDE 扩展中,用 /skills 查看发现结果,或输入 $ 后选择该 Skill。显式请求可写:
$task-status-summary 只读 input/tasks.json,按 Skill 的输出约定汇总。
预期是总数 3、done 1、todo 2,未完成 ID 为 T-02、T-03,数量核对为 1 + 2 = 3。Codex 是否真正选中了 Skill,应看它是否读取了对应入口并遵循约定,不能只看输出碰巧一样。
当前文档说明技能修改会被自动发现;若没有出现,先查目录、文件名、YAML、是否被配置禁用,再尝试重启客户端。不要在不同作用域留下同名但内容不同的副本来碰运气。
故意让输入失败一次
把正常样本复制为 input/tasks-invalid.json,将 T-02 的 status 改成 doing。再次显式调用。
合格行为是指出 T-02 的 status 不在 done/todo 中并停止统计;不能把 doing 擅自当成 todo 后给出完整报告。再把一条记录的 id 改为与 T-01 相同,应报告重复 ID。
最后还原正常样本,重新运行;失败分支修好后,正常输入仍应得到原来的 3/1/2。空数组是合法输入,结果应为 0/0/0,todo ID 为“无”。
什么时候才加入脚本
三条数据可由说明完成;数量变多、需要固定错误码或精确去重时,再把机械校验交给脚本。不要为了看起来完整先塞进脚本、模板、参考资料和几十条规则。
脚本加入后,还要检查“Skill 被触发”和“脚本真的按参数执行”两层;下一篇路径调试案例给出完整脚本与跨目录验证。业务中若输入、处理步骤或验收仍常变,先保留普通任务,等稳定后再维护 Skill。
资料来源
- OpenAI Skills
2026-10-11 核对 SKILL.md、项目发现目录和显式调用。
下一步
继续阅读与你当前问题相关的教程: